作成:音声技術エキスパート/補足編集:ナレッジ記事ライター/2026-09-30
要点
- 従来の音声AIは「STT→LLM→TTS」のバケツリレー(カスケード型)でした。それぞれの工程で待ち時間が積み上がり、声色や感情などの情報も文字にする段階で失われていました。
- GPT-4o系やKyutaiのMoshiは、音声をそのまま入出力する「音声ネイティブ」モデルです。Moshiはさらに、聞くことと話すことを同時に行う「全二重(フルデュプレックス)」を実現しています。
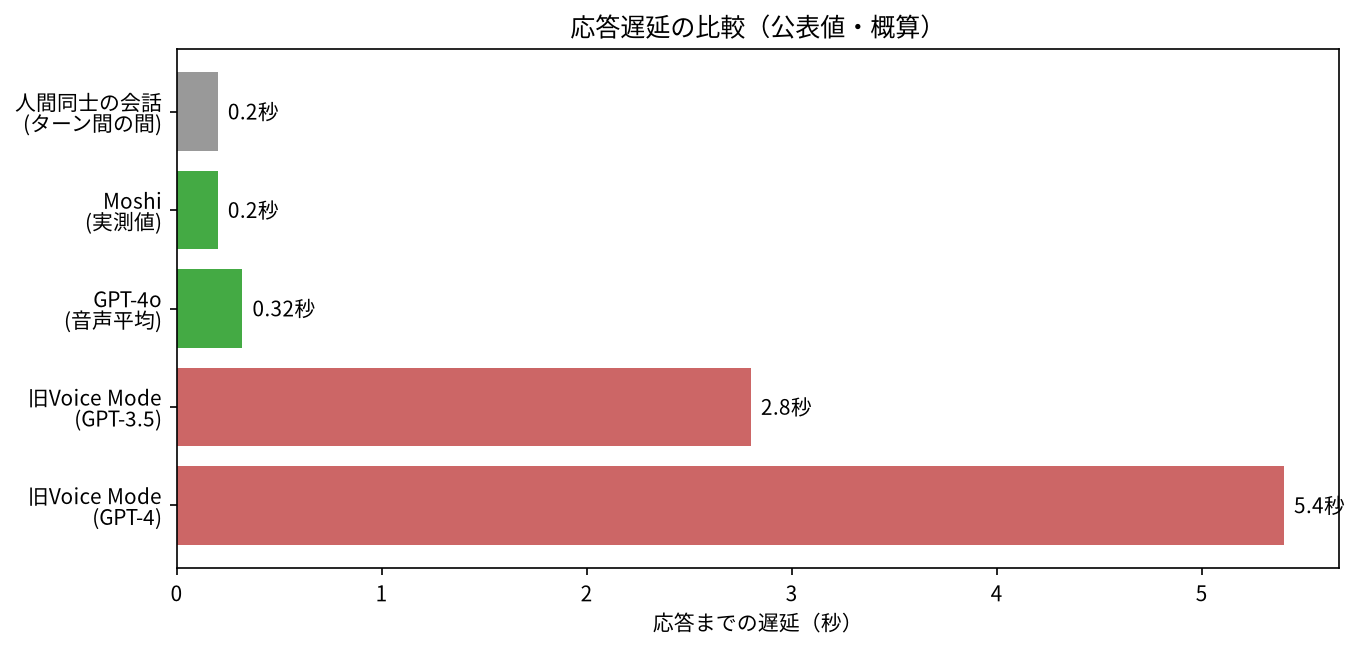
- 公表されている応答遅延は、GPT-4oが平均約320ms(OpenAI発表、2024年)、Moshiが約200ms(論文報告値、2024年)です。測定条件が異なるため単純比較はできませんが、人間同士の会話でターンが切り替わるときの間(約200ms)に近い水準です。
- コンタクトセンターでは、相づち・割り込み・感情に配慮した応対が可能になります。一方で、制御のしやすさ、誤情報、なりすまし対策が新しい課題になります。
音声ネイティブAIと全二重対話は同じですか?
音声をモデルが扱う方式と、相手の発話を聞きながら話せる対話動作は別の軸です。音声を直接扱うことだけで全二重の会話を保証せず、実際の入出力と割り込み動作を確認します。
💡 やさしい補足:この記事を一言でいうと「AIが、人と同じように“聞きながら話せる”ようになってきた」という話です。以下、専門用語には都度かみくだいた説明を添えます。
0. 2つの軸を分けて考える
| 軸 | 何についての分類か | 例 |
|---|---|---|
| 音声ネイティブ/カスケード | 音声をモデルが直接扱うか、文字に変換して扱うか | GPT-4o系=音声ネイティブ、STT→LLM→TTS=カスケード |
| 全二重/半二重 | 聞きながら話せるか、交互にしか話せないか | Moshi=モデル構造として全二重 |
音声ネイティブでも、ターン検出を組み合わせて交互に話す実装はあり得ます。2つは独立した軸です。
1. 人の会話は「同時通行」
電話で話しているとき、私たちは相手の話の途中で「ええ」「はい」と相づちを打ちます。相手が言いよどめば言葉を補い、話がかぶれば譲り合います。会話分析の研究では、ターンが切り替わるときの間は言語を問わずおおむね200ms前後だと報告されています(Stivers et al., 2009, PNAS)。0.2秒で返せるということは、人は相手が話し終わる前から返事の準備を始めていることになります。
通信の用語では、片方ずつしか話せないトランシーバーのような方式を「半二重」、電話のように双方が同時に話せる方式を「全二重」と呼びます。従来の音声AIは、回線は全二重でも、振る舞いは半二重でした。
💡 やさしい補足:200msはまばたき1回ほどの時間です。人は相手の話を聞きながら、同時に次の言葉を準備しています。従来のAIは「相手が完全に黙るまで待ってから考え始める」ため、どうしてもワンテンポ遅れていました。
2. 従来方式:カスケード型の仕組みと限界(図1上段)
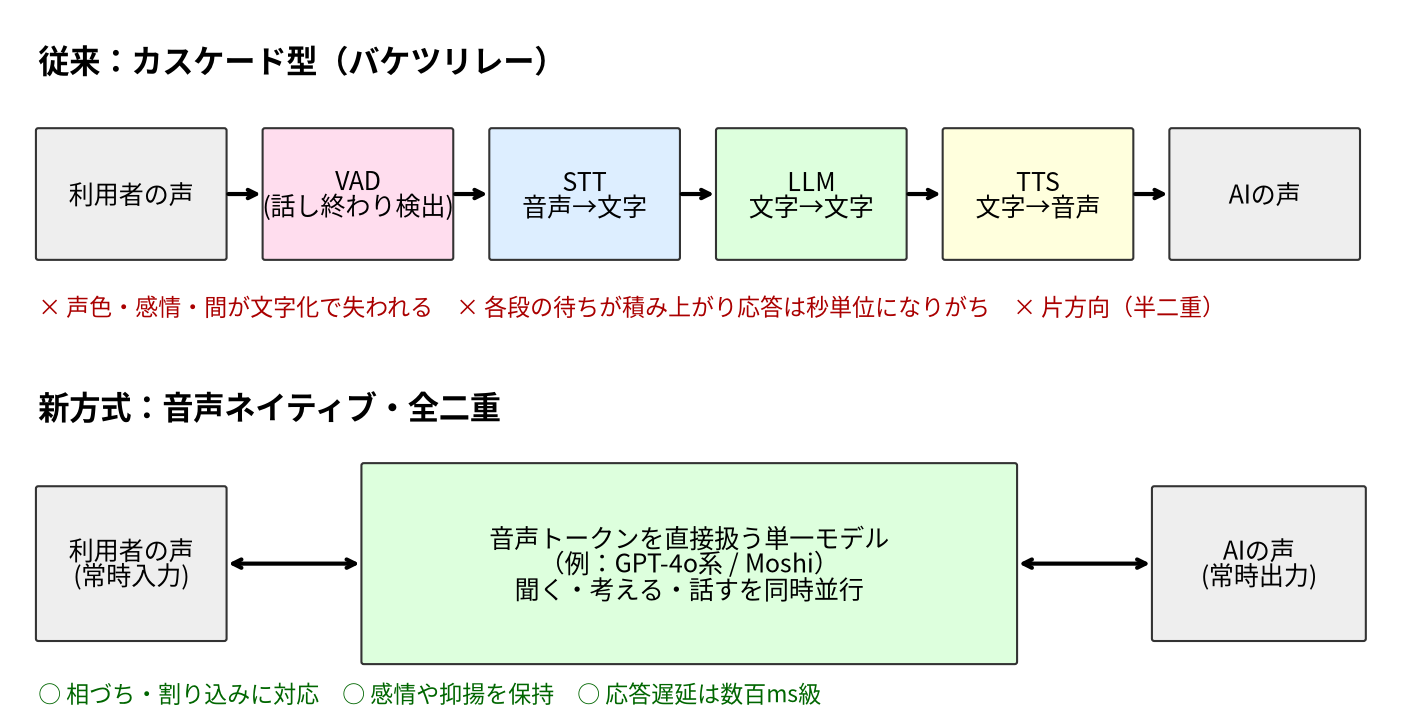
典型的な音声ボットは、次の順で処理します。
- VAD(音声区間検出):無音が一定時間(例:500〜800ms)続いたら「話し終わった」と判断する
- STT:音声を文字に変換する
- LLM:文字で返答を考える
- TTS:返答の文字を音声にする
この方式には、構造的な限界が3つあります。
- 遅延の積み上がり:話し終わりの判定待ち+STT+LLMの最初の出力+TTSの最初の音、が足し算になります。OpenAIの発表(2024年5月)によると、GPT-4o以前のVoice Modeは平均2.8秒(GPT-3.5)〜5.4秒(GPT-4)かかっていました。
- 情報の欠落:文字にした時点で、声のトーン、怒りや焦り、笑い、話者が複数いることなどが落ちてしまいます。OpenAIも旧方式について「トーン、複数話者、背景音を直接観測できず、笑いや歌、感情を出力できない」と説明しています。
- ターンの硬直:「無音になったら自分の番」というルールなので、相づちを打たれると割り込まれたと誤解したり、言いよどんでいる途中で返事を始めたりします。
もちろん、カスケード型も改良が進んでいます。ストリーミングSTT/TTS、LLMの逐次出力、割り込み(バージイン)検知、意味を見て話し終わりを判定するモデルなどを組み合わせると、1秒を切る構成も実用的になっています。現場ではまだ主流の方式です。
💡 やさしい補足:カスケード型は「通訳を3人並べた伝言ゲーム」のようなものです。①聞き取り係が文字に書き起こし、②考える係が返事を書き、③読み上げ係が声に出す。係が交代するたびに待ち時間が生まれ、しかも①の段階で“声の調子”というメモが捨てられてしまいます。
3. 新方式①:音声ネイティブ(GPT-4o系)
GPT-4o(2024年5月発表)は、テキスト・画像・音声をひとつのニューラルネットワークで端から端まで学習したモデルです。音声への応答は最短232ms、平均320msと公表されています(OpenAIの発表値。測定条件の詳細は発表を参照)。
一般的な方式の説明:音声ネイティブモデルでは、音声をニューラル音声コーデックなどで短い単位の記号列(音声トークン)に変換し、言語モデルが文字と同じように読み書きする方式が知られています(Moshiの論文などで公開されている方式)。
GPT-4oについて:GPT-4oが内部でどのような音声表現・コーデックを使っているかは公開されていません。本記事では、公開されている性質(音声を直接入出力し、口調や感情を扱える)だけを記載します。
💡 やさしい補足:「音声トークン」は、声を細かく刻んだ“音のスタンプ”のようなものです。これまでAIは声を一度文字に翻訳してから読んでいましたが、音声ネイティブのAIは一般に、スタンプのまま直接読み書きします。翻訳を挟まないぶん速く、怒っている・笑っているといったニュアンスも残ります。
開発者向けには、OpenAIがRealtime API(2024年10月にベータ公開、2025年8月に一般提供と『gpt-realtime』を発表)で提供しています。
補足:GPT-4o系は割り込みや相づちに対応していますが、内部が完全な全二重なのか、サーバー側のターン検出と組み合わせているのかは、詳しく公開されていません(推測を含みます)。Realtime APIでは、VADによるターン検出の設定が用意されています。
💡 やさしい補足:WebSocket/WebRTCは「つなぎっぱなしの双方向回線」、SIPは「電話網につなぐための共通ルール」と考えてください。つまり、既存のコールセンターの電話にも組み込める入口が用意されている、ということです。
4. 新方式②:全二重(Kyutai Moshi)
フランスの非営利研究所Kyutaiが2024年に公開したMoshiは、全二重をモデルの構造そのもので実現した代表例です(論文:Défossez et al., arXiv:2410.00037)。コードと重みも公開されています(コード:github.com/kyutai-labs/moshi)。
仕組みのポイントは次の4つです。
- 2本の音声ストリームを同時にモデル化:「ユーザーの声」と「Moshi自身の声」を並列の流れとして常に扱います。ターンという概念がそもそもなく、黙る・相づちを打つ・話しかぶる、をモデルが自分で選びます。
- Mimi(ニューラル音声コーデック):音声を12.5Hz(80msに1フレーム)、約1.1kbpsという低いビットレートでトークン化します。意味の情報と音響の情報を両方持つ設計です。
- Helium(約70億パラメータのテキストLLM)を土台にし、階層的なTransformerで時間方向とトークン方向を分けて生成します。
- Inner Monologue(内なる独白):自分が話す音声トークンの前に、対応するテキストトークンを予測させます。「頭の中で文を考えながら話す」ようなもので、言語的な質を高めています。
💡 やさしい補足:Moshiは「自分の耳と口を同時に動かし続けるAI」です。従来のAIが“話す番・聞く番”を交代するのに対し、Moshiには番という考え方がありません。人間のように、聞きながら「うん」と相づちを打ったり、相手が話し始めたら自然に黙ったりを自分で判断します。12.5Hzとは、1秒間を12.5コマに区切って音を扱うという意味です。パラパラ漫画のコマ数のようなものです。
遅延は、理論値160ms(フレーム80ms+音響遅延80ms)、実測約200msと論文で報告されています(論文の実験環境での値)。日本語でも、名古屋大学などのグループがMoshiをもとにした日本語全二重対話モデル「J-Moshi」を公開しています。
💡 やさしい補足:理論値160msは、1コマ(80ms)を聞いて、1コマ(80ms)ぶん遅らせて話し始めるという計算です。人間のターン間(約200ms)とほぼ同じ速さです。
5. 比較(図2)
| 観点 | カスケード型 | 音声ネイティブ(GPT-4o系) | 全二重(Moshi) |
|---|---|---|---|
| 応答遅延 | 数百ms〜数秒(構成次第) | 平均約320ms(OpenAI発表値, 2024) | 約200ms(論文報告値, 2024) |
| 感情・声色 | 文字化で失われる | 保持される | 保持される |
| 相づち・かぶり | 苦手 | 対応(方式の詳細は非公開) | 構造的に対応 |
| 制御・監査のしやすさ | 高い(各段にログ) | 中 | 低〜中 |
| 知識・推論力 | 最新LLMを自由に選べる | 高い | 小型モデルのため限定的 |
注:各値は発表元・測定条件が異なります。自社の電話回線・構成での実測が前提です。
💡 やさしい補足:表の読み方は「速さ・自然さ」と「管理しやすさ・賢さ」のトレードオフです。右に行くほど会話は人間らしくなりますが、中で何が起きているかは見えにくくなります。どれか1つが万能というわけではありません。
6. コンタクトセンターでの意味
期待できること
- 自然なIVR・ボイスボット:「えーと」と言っている途中で切られない、相づちが返ってくる、割り込めばすぐ止まる。こうした体験の差は、離脱率に効きます。
- 感情への配慮:苛立った声を検知して、話す速さや口調を変えたり、早めに人の担当者へつないだりできます。
注意すべきこと
- 制御と監査:カスケード型は文字のログで確認・フィルタリングしやすい構造です。音声ネイティブ型は、何をどう理解したのかが見えにくくなります。多くの実装では、並行して文字起こしを出力する仕組みで補っています。
- 誤情報とツール連携:本人確認、決済、CRM更新などは、関数呼び出し(function calling)で外部システムに任せ、最終確認を明示的に行う設計が必要です。業務を最後まで完了できたかの検証はAIエージェントは業務を完了できたか?Botiumで考える結果の検証をご覧ください。
- 電話回線の音質:8kHzの狭帯域音声、雑音、遅延の揺らぎによって、公表値どおりの遅延や精度が出ないことがあります(推測を含みます。実環境での検証をおすすめします)。遅延の内訳と測り方は音声遅延はどこで発生するのか|片方向遅延・RTT・会話品質、音声ボットの試験は音声ボットのテスト方法とは?認識・会話・応答音声を分けて確認で解説しています。
- 声のなりすまし:自然な音声生成は、音声クローン詐欺と表裏一体です。AIであることの明示と、声だけに頼らない本人確認の強化が必要です。
現実的な落としどころとしては、当面は「重要な処理はカスケード型+ツール連携、会話の自然さは音声ネイティブ」という組み合わせが増えると見ています(推測)。
💡 やさしい補足:コンタクトセンターに置き換えると、「受付の雑談や聞き取りは“話上手な新人(音声ネイティブ)”、本人確認や契約変更は“手順書どおりに動くベテラン(カスケード型+システム連携)”」という役割分担のイメージです。
7. 用語ミニ辞典
- 全二重/半二重:同時に双方向で話せる方式/片方ずつしか話せない方式
- VAD:音声区間検出(人が話しているかどうかを判定する技術)
- バージイン:AIの発話中に、利用者が割り込んで話すこと
- ニューラル音声コーデック:音声を少数の離散トークンに圧縮・復元するニューラルネット(例:Mimi、EnCodec)
- TTFB/初音遅延:話し終わってから、最初の音が返ってくるまでの時間
出典
- OpenAI「Hello GPT-4o」(2024-05-13):応答遅延232ms/320ms、旧Voice Modeの2.8秒/5.4秒
- OpenAI「Introducing the Realtime API」(2024-10)、「Introducing gpt-realtime」(2025-08)
- Défossez et al., “Moshi: a speech-text foundation model for real-time dialogue“, arXiv:2410.00037(Kyutai, 2024)、github.com/kyutai-labs/moshi
- Stivers et al., “Universals and cultural variation in turn-taking in conversation“, PNAS 106(26), 2009
- J-Moshi:nu-dialogue/j-moshi(GitHub/Hugging Face)
CC Assuranceのサービス
新方式の音声AIを導入する前に、自社回線での遅延・割り込み動作・業務完了までを確かめたい場合はご相談ください。